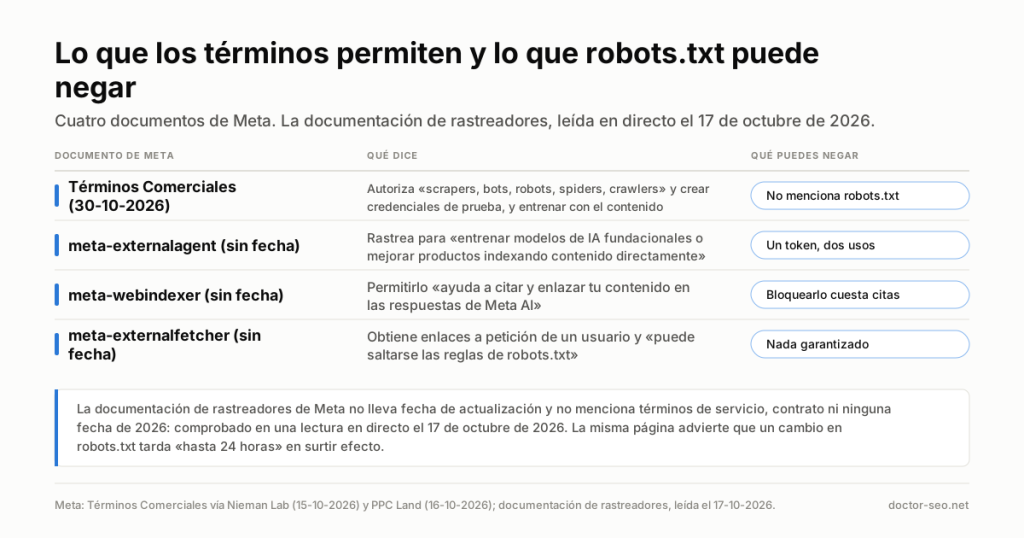
Los Términos Comerciales revisados de Meta entran en vigor el 30 de octubre de 2026 y traen una cláusula que la versión a la que sustituyen no tenía. Toda empresa que use productos de Meta autoriza a Meta a dirigir software automatizado contra las webs de esa misma empresa, y a usar lo que encuentre allí para entrenar los productos de Meta.
No hay nada que firmar. La aceptación es por uso continuado: si publicas en una página de Facebook el 31 de octubre, has aceptado. No existe una exclusión parcial y, a día de hoy, no existe ninguna exclusión salvo dejar de usar los productos de Meta con fines comerciales.
Qué dice la nueva cláusula
La cláusula está en la sección 1 de los Términos Comerciales, una sección que pasa de titularse «Licencias» a «Licencias y derechos que concedes a Meta». El original está en inglés; esta es la traducción completa:
«Nos autorizas (o a cualquier entidad que actúe en nuestro nombre) a usar software automatizado (como web scrapers, bots, robots, spiders, crawlers y agentes de usuario) y a crear credenciales de prueba para acceder, indexar, cachear, analizar, recopilar, recuperar o rastrear los dominios, páginas web o URL (y cualquier contenido disponible a través de ellos) que estén asociados a tus productos o servicios, o que se pongan a disposición mediante tu uso o el de los usuarios de los Productos y servicios de las Empresas de Meta, y a extraer periódicamente actualizaciones de dichos dominios, páginas web o URL. Meta podrá usar cualquier contenido de dichos dominios, páginas web o URL para proporcionar, desarrollar, mejorar, investigar, entrenar y mantener la integridad de los Productos, servicios y funciones de las Empresas de Meta prestados conforme a estos Términos Comerciales y a cualesquiera otros términos complementarios aplicables.»
Las expresiones operativas del original, en inglés, son web scrapers, bots, robots, spiders, crawlers, and user agents, create test credentials y provide, develop, improve, research, train.
Cómo ha llegado esa cita a este artículo. Las páginas legales de Meta prohíben el acceso automatizado, así que el texto no se pudo leer en facebook.com durante esta sesión. Procede de dos transcripciones independientes: Nieman Lab (Andrew Deck y Hanaa’ Tameez, 15 de octubre de 2026) y PPC Land (Luis Rijo, 16 de octubre de 2026). Coinciden palabra por palabra y difieren exactamente como deben diferir dos lecturas de ediciones lingüísticas distintas de un mismo documento: Nieman Lab escribe authorize y analyze, PPC Land escribe authorise y dice haber leído la edición en inglés británico. Eso corrobora la transcripción, no el documento.
Cómo se acepta, y qué cuesta negarse
La aceptación es pasiva. PPC Land cita la sección 7: al seguir accediendo o usando cualquier producto de las Empresas de Meta con fines comerciales después de recibir aviso de una actualización de estos Términos Comerciales, quedas obligado por ellos. Nieman Lab informa de que Meta avisó a los usuarios de empresa a principios de octubre mediante una entrada de blog y en Meta Business Suite.
El ámbito es el uso comercial, no la publicidad: entre los ejemplos que PPC Land recoge de la versión nueva están listar productos, usar un catálogo de productos y usar cualquier producto de empresa como Ads Manager o Meta Business Suite. Search Engine Journal (Matt G. Southern, 16 de octubre de 2026) lo lee igual y lo lleva al titular: la concesión alcanza a empresas que nunca compran publicidad. El propio seguimiento de PPC Land del 17 de octubre de 2026 lo enmarca de forma más estrecha, como las webs de los anunciantes. Dos piezas del mismo autor con un día de diferencia describen el ámbito de manera distinta, y el encuadre estrecho es el que el texto de la cláusula no sostiene.
Sobre cómo negarse, las dos transcripciones divergen en una palabra. Nieman Lab cita «por favor, deja de acceder o usar nuestros Productos con fines comerciales»; PPC Land sostiene que ese «por favor, deja» es la redacción de marzo de 2024 y que la versión del 30 de octubre dice «puedes dejar». Este artículo no puede dirimir cuál figura hoy en la página, y ambas apuntan a lo mismo: Nieman Lab informa de que «actualmente no existe ninguna opción para que las cuentas de empresa se excluyan de estos nuevos términos antes del 30 de octubre».
Qué dice la propia documentación de rastreadores de Meta
Meta publica una página con sus rastreadores web y la forma de controlarlos. Leída en directo el 17 de octubre de 2026, nombra cinco tokens de agente de usuario, y el mecanismo de control que declara es robots.txt: según esa página, Meta facilita que gestores de sitios y propietarios de contenido indiquen sus preferencias «usando prácticas estándar del sector como robots.txt en lugar de formatos no estándar como las etiquetas NoAI».
Preguntada de forma explícita, esa página no menciona términos de servicio, ni contrato, ni ninguna fecha de 2026, y no lleva marca de última actualización. Los Términos Comerciales, en ambas transcripciones, no mencionan robots.txt. Es decir: los dos documentos de Meta que gobiernan la misma conducta —qué puede llevarse el software de Meta de tu sitio y qué puedes hacer tú al respecto— no se remiten el uno al otro en ninguna dirección.
Los tokens tampoco encajan con las finalidades que un propietario querría negar. Meta-ExternalAgent «rastrea la web para casos de uso como entrenar modelos de IA fundacionales o mejorar productos indexando contenido directamente»: un solo token que cubre dos finalidades que cualquier editor valoraría por separado. Un único Disallow niega las dos, y no hay forma documentada de negar el entrenamiento y conservar la indexación.
Meta-WebIndexer «navega por la web para mejorar la calidad de los resultados de búsqueda de Meta AI», y la frase de la propia Meta pone precio a la decisión: permitirlo en tu robots.txt «nos ayuda a citar y enlazar tu contenido en las respuestas de Meta AI». Bloquearlo es la negativa más limpia disponible y cuesta exactamente lo que un SEO quiere de una superficie de IA. El mismo dilema, con los rastreadores de otra empresa, es el tema de los tres bots de Claude y tu robots.txt. Y dos de los cinco tokens están documentados como capaces de ignorar el archivo que la propia Meta recomienda: Meta-ExternalFetcher «puede saltarse las reglas de robots.txt» y FacebookExternalHit «podría saltarse robots.txt al realizar comprobaciones de seguridad o integridad».
Qué dijo Meta, y qué dijeron tres abogados
Meta rechaza esa lectura. Andy Stone, responsable de comunicación de la compañía, respondió en X el 16 de octubre de 2026. Ese mensaje no se puede recuperar desde aquí —x.com prohíbe el acceso automatizado—, así que llega a través de la prensa especializada, y no todas las piezas lo reproducen entero. La versión más completa es la de PPC Land: «Esto es falso. No hay ningún cambio en cómo Meta usa los rastreadores web. Como siempre, los propietarios de contenido pueden usar las marcas de robots.txt para indicar sus preferencias. Esta actualización está pensada para asegurar que podemos extraer información precisa sobre productos a la venta en webs de terceros al hacer recomendaciones de anuncios y contenido en la plataforma, no para rastrear webs de noticias». El seguimiento del propio PPC Land un día después cita solo la última frase y deja fuera «esto es falso» y la línea sobre robots.txt. Por separado, un portavoz de Meta dijo a Nieman Lab que la actualización se limita a consolidar un lenguaje sobre rastreo que antes estaba disperso en varios términos de uso, y añadió que «los propietarios de contenido pueden seguir gestionando cómo se accede a su contenido mediante robots.txt». Meta declinó responder al cuestionario de Nieman Lab y declinó aclarar si las credenciales de prueba sortearían los muros de pago.
Nieman Lab pidió a tres abogados que leyeran los términos. Matt Topic, de Loevy & Loevy, la calificó de «una disposición notable para enterrarla en unos términos de servicio» y añadió: «No está claro si un tribunal la haría cumplir, pero los editores deberían asumir que sería exigible». Benjamin Sobel, de la Universidad de Wisconsin, resumió el atolladero: «Si quieres usar los productos de Meta que exigen aceptar los términos comerciales, también tienes que consentir los permisos de scraping y rastreo que esos términos imponen». James Grimmelmann, de Cornell, lo leyó como permiso para entrenar con cualquier contenido del sitio de un editor. Nieman Lab añade, sin atribuirlo a ninguno, que la nueva redacción «abre la puerta a que Meta argumente que sus términos comerciales prevalecen sobre otras instrucciones de bloqueo». Nadie lo ha puesto a prueba.
Qué cambia en la práctica
Técnicamente, es posible que nada. La afirmación de Stone de que no hay cambio en cómo Meta usa los rastreadores no la contradice nada de lo publicado: la documentación de rastreadores no lleva ninguna fecha de 2026, así que no hay ningún cambio documentado de conducta al que apuntar.
Contractualmente, el cambio es justo eso. Antes del 30 de octubre, quien bloquea meta-externalagent está negando una petición. Después del 30 de octubre, si la cláusula obliga, esa misma persona ha concedido además un permiso: dos cosas distintas expresadas en el mismo archivo. Nada en la documentación de Meta dice que una regla de robots.txt retire la concesión, y nada en los términos dice que la concesión se imponga al archivo. No es una contradicción entre los documentos; es una pregunta que ninguno de los dos responde. Para quien hace SEO técnico, la consecuencia es más estrecha que los titulares y más incómoda: la decisión tiene ahora una fecha, la granularidad disponible es peor que la de la concesión, y la negativa más limpia cuesta visibilidad en una superficie de respuesta con IA.
Qué hacer antes del 30 de octubre
Empieza por leer lo que ya publicas:
curl -s https://ejemplo.com/robots.txt | grep -iE 'meta-external(agent|ads|fetcher)|meta-webindexer|facebookexternalhit'Si no devuelve nada, no estás tratando ninguno de los cinco tokens de Meta y los estás permitiendo todos por omisión. Luego decide uno a uno, porque hacen cosas distintas:
| Token | Qué dice Meta que hace | Qué cuesta bloquearlo |
|---|---|---|
meta-externalagent |
Entrenar modelos de IA fundacionales, o indexar contenido para mejorar productos | Las dos cosas a la vez: un token, sin separación |
meta-webindexer |
Mejora la calidad de búsqueda de Meta AI; permitirlo «ayuda a citar y enlazar tu contenido» | Citas y enlaces en las respuestas de Meta AI |
meta-externalads |
Mejorar la publicidad y otros productos de empresa | Meta no lo indica |
meta-externalfetcher |
Obtiene enlaces a petición de un usuario; «puede saltarse las reglas de robots.txt» | Quizá nada: puede que la regla no se respete |
facebookexternalhit |
Construye la tarjeta de vista previa cuando alguien comparte un enlace | Tus vistas previas en Facebook, Instagram y Messenger |
- Guarda una copia fechada de tu robots.txt tal como está antes del 30 de octubre. Dejar constancia de qué permitías y desde cuándo es barato ahora e imposible de reconstruir después.
- Haz cualquier cambio el 28 de octubre, no el 29. La propia página de Meta pide «hasta 24 horas para que los cambios en
robots.txtsurtan efecto, porque los rastreadores pueden cachear su contenido hasta 24 horas», así que un archivo editado la víspera puede no estar en vigor cuando lo estén los términos. - No des por hecho que bloquear lo zanja. En el registro documentado, un
Disallowes una preferencia técnica y la cláusula es un permiso contractual, y ninguna fuente publicada dice que lo primero retire lo segundo.
Dónde el sector discrepa de verdad
Si una concesión contractual cambia lo que consigue robots.txt. Un bando sostiene que un rastreador que respeta un Disallow no se lleva el contenido, permita lo que permita un contrato, y que la propia Meta remite una y otra vez al archivo. El otro sostiene que un permiso que has concedido no queda deshecho por una preferencia que expresas, y los abogados consultados por Nieman Lab dicen que la redacción abre precisamente esa puerta. Ningún tribunal se ha pronunciado sobre esta cláusula y Meta no ha publicado nada que concilie los dos documentos.
Si bloquear un token de uso mixto niega la finalidad que te molesta. Un bando dice que el token es la única granularidad que ofrece el estándar, así que bloquearlo niega todo lo que hace. El otro dice que verse obligado a renunciar a la indexación para negar el entrenamiento es un paquete y no un consentimiento, y que negar solo el entrenamiento no está disponible. No hay ninguna medición en ninguna de las dos direcciones.
Si los sitios deberían bloquear a los rastreadores de IA. Este sitio no tiene posición y no la toma aquí. El análisis de Cloudflare Radar sobre unos 4.000 archivos robots.txt (31 de agosto de 2026) encontró que los bots de entrenamiento se bloquean entre dos y tres veces más de lo que se permiten, mientras que los bots de respuesta quedan netamente permitidos: eso describe lo que hacen los editores, no si aciertan, y el lado de las citas es donde se nota el coste.
Si la descripción que hace un directivo de una conducta es prueba de esa conducta. Stone dice que no hay cambio en cómo Meta usa los rastreadores: una afirmación sobre la conducta de la parte que la hace, en una plataforma que este sitio no puede leer directamente, y Meta no publica ningún registro de cambios de sus rastreadores con el que contrastarla. La pregunta emparentada, viva en toda superficie agéntica, es si una obtención hecha a petición de un usuario debería regirse por robots.txt: Meta documenta meta-externalfetcher como capaz de saltárselo, y nadie ha medido qué presenta realmente esa petición.
Lo que pienso
Defiendo una sola afirmación: los dos documentos de Meta que gobiernan esto no se encuentran. Los Términos Comerciales autorizan la recopilación automatizada y el entrenamiento y, en ambas transcripciones disponibles, no mencionan robots.txt. La documentación de rastreadores ofrece robots.txt como control y, verificado en una lectura en directo el 17 de octubre de 2026, no menciona términos, ni contrato, ni ninguna fecha de 2026. El portavoz de Meta y su responsable de comunicación remiten a los propietarios a un archivo que el documento que manda no comenta. Cualquiera puede comprobarlo en cinco minutos.
Lo que no voy a decir es si has perdido algo. No sé si un tribunal consideraría exigible la cláusula; uno de los tres abogados dijo con todas las letras que no está claro. No te voy a decir que bloquear sea inútil, porque ninguna fuente dice que la concesión venza al archivo, ni que bloquear sea suficiente, porque ninguna fuente dice que retire la concesión. Las dos frases se están escribiendo esta semana por gente que no sabe ni lo uno ni lo otro. La lectura honesta es más aburrida que los titulares: se le ha puesto fecha a una decisión que casi todo el mundo venía aplazando, y los controles disponibles son más toscos que el permiso que se concede. Eso merece dos horas de la semana de alguien y no merece una crisis.
Lo que sigue sin saberse
Si la cláusula es exigible. Si «asociados a tus productos o servicios» alcanza a un dominio entero o solo a las fichas de producto: PPC Land señala que los términos no lo definen. Si las credenciales de prueba sortearían los muros de pago; Meta declinó responderlo. A cuántos sitios afecta: nadie ha publicado un recuento. Y si cambia algo en la conducta de los rastreadores, cosa que Meta niega y que ninguna parte externa puede medir.
Fuentes
- Meta, Términos Comerciales, en vigor el 30 de octubre de 2026. La página prohíbe el acceso automatizado y no se pudo leer en esta sesión; citada a través de las dos transcripciones siguientes.
- Meta, documentación para desarrolladores Meta Web Crawlers. Leída en directo el 17 de octubre de 2026; la página no lleva fecha de actualización.
- Andrew Deck y Hanaa’ Tameez, «Meta’s new commercial terms will allow the scraping of news sites, legal experts say», Nieman Lab, 15 de octubre de 2026.
- Luis Rijo, «Meta’s new terms let it crawl business websites to train AI from Oct 30», PPC Land, 16 de octubre de 2026.
- Luis Rijo, «Meta grants itself the right to crawl advertisers’ websites for AI», PPC Land, 17 de octubre de 2026.
- Matt G. Southern, «Meta’s New Terms Expand Crawling Rights Beyond Advertisers», Search Engine Journal, 16 de octubre de 2026.
- Andy Stone, mensaje en X, 16 de octubre de 2026. No recuperable en este entorno; citado desde la transcripción de PPC Land del 16 de octubre de 2026.
- Cloudflare Radar, análisis de robots.txt sobre unos 4.000 dominios, 31 de agosto de 2026.