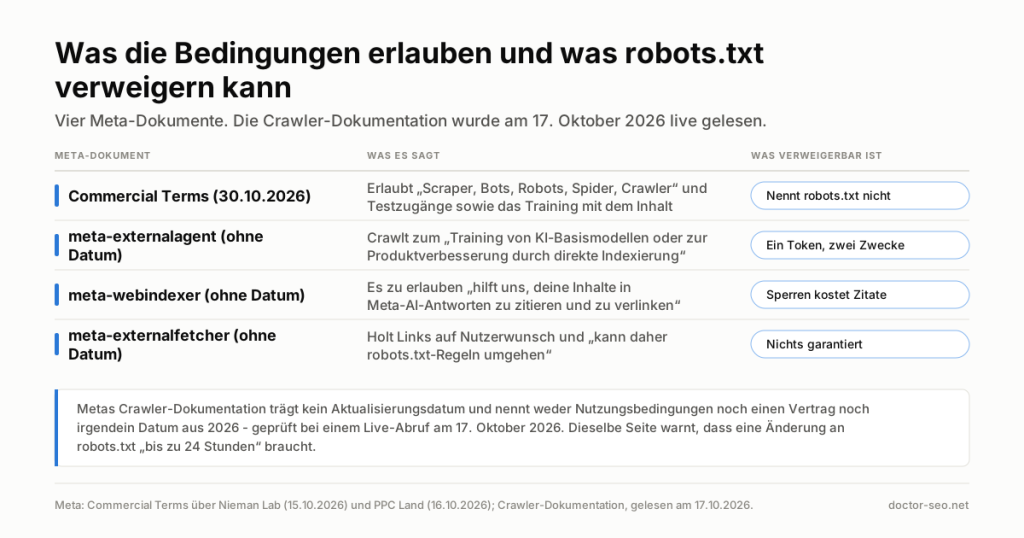
Metas überarbeitete Commercial Terms gelten ab dem 30. Oktober 2026, und sie enthalten eine Klausel, die in der abgelösten Fassung nicht stand. Jedes Unternehmen, das Produkte von Meta nutzt, erlaubt Meta damit, automatisierte Software auf die eigenen Websites dieses Unternehmens zu richten – und erlaubt Meta, das dort Gefundene zum Training von Metas Produkten zu verwenden.
Es gibt nichts zu unterschreiben. Die Zustimmung erfolgt durch weitere Nutzung: Wer am 31. Oktober etwas auf einer Facebook-Seite postet, hat zugestimmt. Einen teilweisen Widerspruch gibt es nicht, und bis heute überhaupt keinen Widerspruch außer der Einstellung jeder geschäftlichen Nutzung von Meta-Produkten.
Was die neue Klausel sagt
Die Klausel steht in Abschnitt 1 der Commercial Terms, einem Abschnitt, der von „Lizenzen“ in „Lizenzen und Rechte, die du Meta einräumst“ umbenannt wurde. Das Original ist englisch; hier die vollständige Übersetzung:
„Du autorisierst uns (oder jede in unserem Auftrag handelnde Stelle), automatisierte Software (etwa Web-Scraper, Bots, Robots, Spider, Crawler und User Agents) einzusetzen und Testzugänge anzulegen, um auf die Domains, Webseiten oder URLs (und alle darüber verfügbaren Inhalte) zuzugreifen, sie zu indexieren, zwischenzuspeichern, zu analysieren, zu erfassen, abzurufen oder zu crawlen, die mit deinen Produkten oder Leistungen verbunden sind oder die durch deine Nutzung oder die Nutzung der Meta-Produkte und -Dienste durch Nutzer zugänglich gemacht werden, und um regelmäßig Aktualisierungen von diesen Domains, Webseiten oder URLs abzurufen. Meta darf sämtliche Inhalte dieser Domains, Webseiten oder URLs verwenden, um die Produkte, Dienste und Funktionen der Meta-Unternehmen bereitzustellen, zu entwickeln, zu verbessern, zu erforschen, zu trainieren und deren Integrität zu wahren, soweit sie unter diesen Commercial Terms und etwaigen weiteren geltenden Zusatzbedingungen erbracht werden.“
Die maßgeblichen Formulierungen lauten im englischen Original web scrapers, bots, robots, spiders, crawlers, and user agents, create test credentials und provide, develop, improve, research, train.
Wie dieses Zitat in diesen Artikel gelangt ist. Metas Rechtsseiten untersagen den automatisierten Abruf, der Wortlaut war also während dieses Laufs auf facebook.com nicht lesbar. Er stammt aus zwei unabhängigen Wiedergaben: Nieman Lab (Andrew Deck und Hanaa’ Tameez, 15. Oktober 2026) und PPC Land (Luis Rijo, 16. Oktober 2026). Beide stimmen Wort für Wort überein und weichen genau so voneinander ab, wie zwei Lesungen verschiedener Sprachfassungen desselben Dokuments abweichen sollten: Nieman Lab schreibt authorize und analyze, PPC Land schreibt authorise und gibt an, die britische Fassung gelesen zu haben. Das bestätigt die Transkription, nicht das Dokument.
Wie ein Unternehmen zustimmt – und was eine Ablehnung kostet
Die Zustimmung ist passiv. PPC Land zitiert Abschnitt 7: Wer nach einem Hinweis auf eine Aktualisierung dieser Commercial Terms weiterhin auf Meta-Produkte zu geschäftlichen Zwecken zugreift oder sie nutzt, ist an sie gebunden. Nieman Lab berichtet, Meta habe Geschäftskunden Anfang Oktober über einen Blogbeitrag und in der Meta Business Suite informiert.
Der Anwendungsbereich ist die geschäftliche Nutzung, nicht die Werbung: Zu den Beispielen, die PPC Land aus der neuen Fassung nennt, gehören das Listen von Produkten, die Nutzung eines Produktkatalogs und die Nutzung jedes Geschäftsprodukts wie Ads Manager oder Meta Business Suite. Search Engine Journal (Matt G. Southern, 16. Oktober 2026) liest es genauso und setzt es in die Überschrift: Die Einräumung erfasst auch Unternehmen, die nie Anzeigen schalten. PPC Lands eigener Folgebeitrag vom 17. Oktober 2026 fasst es enger und spricht von den Websites der Werbetreibenden. Zwei Texte desselben Autors im Abstand eines Tages beschreiben den Anwendungsbereich unterschiedlich, und die engere Fassung ist diejenige, die der Klauseltext nicht trägt.
Bei der Ablehnung weichen die beiden Wiedergaben um ein einziges Wort ab. Nieman Lab zitiert „bitte stelle jeden Zugriff auf unsere Produkte zu geschäftlichen Zwecken ein“; PPC Land hält dieses „bitte stelle ein“ für den Wortlaut von März 2024 und gibt die Fassung vom 30. Oktober mit „du kannst einstellen“ wieder. Dieser Artikel kann nicht klären, was heute auf der Seite steht, und beide Lesarten weisen in dieselbe Richtung: Nieman Lab berichtet, es gebe „derzeit keine Möglichkeit für Geschäftskonten, diesen neuen Bedingungen vor dem 30. Oktober zu widersprechen“.
Was Metas eigene Crawler-Dokumentation sagt
Meta veröffentlicht eine Seite mit seinen Webcrawlern und deren Steuerung. Live gelesen am 17. Oktober 2026, nennt sie fünf User-Agent-Tokens, und als Steuerungsmechanismus nennt sie robots.txt: Meta mache es Seitenbetreibern und Inhabern von Inhalten leicht, ihre Präferenzen „über branchenübliche Verfahren wie robots.txt statt über nicht standardisierte Formate wie NoAI-Tags“ anzugeben.
Ausdrücklich danach gefragt, nennt diese Seite keine Nutzungsbedingungen, keinen Vertrag und kein einziges Datum aus 2026, und sie trägt kein Aktualisierungsdatum. Die Commercial Terms nennen in beiden Wiedergaben robots.txt nicht. Die beiden Meta-Dokumente, die dasselbe Verhalten regeln – was Metas Software von deiner Website mitnehmen darf und was du dagegen tun kannst –, verweisen also in keiner Richtung aufeinander.
Die Tokens passen auch nicht zu den Zwecken, die ein Seitenbetreiber verweigern möchte. Meta-ExternalAgent „crawlt das Web für Anwendungsfälle wie das Training von KI-Basismodellen oder die Verbesserung von Produkten durch direkte Indexierung von Inhalten“ – ein einziges Token für zwei Zwecke, die ein Publisher getrennt abwägen würde. Ein einzelnes Disallow verweigert beide, und es gibt keinen dokumentierten Weg, das Training zu verweigern und die Indexierung zu behalten.
Meta-WebIndexer „durchsucht das Web, um die Qualität der Meta-AI-Suchergebnisse zu verbessern“, und Metas eigener Satz beziffert den Preis der Entscheidung: Es in der robots.txt zu erlauben, „hilft uns, deine Inhalte in den Antworten von Meta AI zu zitieren und zu verlinken“. Es zu sperren ist die sauberste verfügbare Verweigerung – und sie kostet genau das, was Suchmaschinenoptimierung von einer KI-Oberfläche will. Dieselbe Abwägung, bezogen auf die Crawler eines anderen Unternehmens, ist Thema von Die drei Claude-Crawler und deine robots.txt. Und zwei der fünf Tokens sind ausdrücklich als fähig dokumentiert, die von Meta empfohlene Datei zu ignorieren: Meta-ExternalFetcher „kann robots.txt-Regeln umgehen“, und FacebookExternalHit „könnte robots.txt bei Sicherheits- oder Integritätsprüfungen umgehen“.
Was Meta sagte und was drei Juristen sagten
Meta widerspricht dieser Lesart. Andy Stone, Kommunikationschef des Konzerns, antwortete am 16. Oktober 2026 auf X. Dieser Beitrag lässt sich von hier aus nicht abrufen – x.com untersagt den automatisierten Zugriff –, er erreicht diesen Artikel also über die Fachpresse, und nicht jeder Text gibt ihn vollständig wieder. Am vollständigsten ist PPC Land: „Das ist falsch. An der Art, wie Meta Webcrawler einsetzt, ändert sich nichts. Wie immer können Inhaber von Inhalten robots.txt-Angaben nutzen, um ihre Präferenzen anzuzeigen. Diese Aktualisierung soll sicherstellen, dass wir genaue Informationen über zum Verkauf stehende Produkte auf Websites Dritter abrufen können, wenn wir auf der Plattform Anzeigen- und Inhaltsempfehlungen ausspielen – es geht nicht darum, Nachrichtenseiten zu scrapen.“ PPC Lands eigener Folgebeitrag einen Tag später zitiert nur den letzten Satz und lässt „Das ist falsch“ und die robots.txt-Zeile weg. Ein Meta-Sprecher sagte Nieman Lab separat, die Aktualisierung fasse lediglich Formulierungen zum Crawling zusammen, die bislang über mehrere Nutzungsbedingungen verstreut gewesen seien, und ergänzte, Inhaber von Inhalten könnten „weiterhin über robots.txt steuern, wie auf ihre Inhalte zugegriffen wird“. Metas Fragenkatalog von Nieman Lab blieb unbeantwortet, ebenso die Frage, ob die Testzugänge Bezahlschranken umgehen würden.
Nieman Lab ließ die Bedingungen von drei Juristen prüfen. Matt Topic von Loevy & Loevy nannte sie „eine bemerkenswerte Bestimmung, um sie in Nutzungsbedingungen zu vergraben“, und fügte hinzu: „Es ist nicht klar, ob ein Gericht das durchsetzen würde, aber Publisher sollten davon ausgehen, dass es durchsetzbar wäre.“ Benjamin Sobel von der University of Wisconsin brachte die Zwangslage auf den Punkt: „Wer die Meta-Produkte nutzen will, die eine Zustimmung zu den Commercial Terms verlangen, muss auch den Scraping- und Crawling-Rechten zustimmen, die diese Bedingungen abverlangen.“ James Grimmelmann von der Cornell-Universität las es als Erlaubnis, mit beliebigen Inhalten einer Publisher-Website zu trainieren. Nieman Lab ergänzt ohne namentliche Zuordnung, die neue Formulierung „eröffnet Meta die Möglichkeit zu argumentieren, dass seine Commercial Terms anderen Sperranweisungen vorgehen“. Geprüft hat das niemand.
Was sich in der Praxis ändert
Technisch möglicherweise nichts. Stones Aussage, an Metas Crawler-Einsatz ändere sich nichts, wird durch nichts im veröffentlichten Bestand widerlegt: Die Crawler-Dokumentation trägt kein Datum aus 2026, es gibt also keine dokumentierte Verhaltensänderung, auf die man zeigen könnte.
Vertraglich ist genau das die Änderung. Vor dem 30. Oktober verweigert, wer meta-externalagent sperrt, eine Anfrage. Nach dem 30. Oktober hat dieselbe Person, falls die Klausel bindet, zusätzlich eine Erlaubnis erteilt – zwei verschiedene Dinge, ausgedrückt in derselben Datei. Nichts in Metas Dokumentation sagt, dass eine robots.txt-Regel die Erlaubnis zurücknimmt; nichts in den Bedingungen sagt, dass die Erlaubnis der Datei vorgeht. Das ist kein Widerspruch zwischen den Dokumenten, sondern eine Frage, die keines von beiden beantwortet. Für technisches SEO ist die Folge enger als die Schlagzeilen und unangenehmer: Die Entscheidung hat jetzt ein Datum, die verfügbare Granularität ist gröber als die der Erlaubnis, und die sauberste Verweigerung kostet Sichtbarkeit auf einer KI-Antwortoberfläche.
Was bis zum 30. Oktober zu tun ist
Fang damit an zu lesen, was du bereits veröffentlichst:
curl -s https://beispiel.de/robots.txt | grep -iE 'meta-external(agent|ads|fetcher)|meta-webindexer|facebookexternalhit'Ein leeres Ergebnis heißt: Du behandelst keines der fünf Meta-Tokens und erlaubst damit standardmäßig alle. Dann entscheide jedes einzeln, denn sie tun Unterschiedliches:
| Token | Wozu es laut Meta dient | Was eine Sperre kostet |
|---|---|---|
meta-externalagent |
Training von KI-Basismodellen oder Indexierung von Inhalten zur Produktverbesserung | Beides zugleich – ein Token, keine Trennung |
meta-webindexer |
Verbessert die Meta-AI-Suche; es zu erlauben „hilft uns, deine Inhalte zu zitieren und zu verlinken“ | Zitate und Links in Meta-AI-Antworten |
meta-externalads |
Verbesserung von Werbung und anderen Geschäftsprodukten | Von Meta nicht angegeben |
meta-externalfetcher |
Holt Links auf Nutzerwunsch; „kann robots.txt-Regeln umgehen“ | Womöglich nichts – die Regel wird vielleicht nicht beachtet |
facebookexternalhit |
Erzeugt die Vorschaukarte, wenn jemand einen Link teilt | Deine Linkvorschauen auf Facebook, Instagram und Messenger |
- Sichere eine datierte Kopie deiner robots.txt im Stand vor dem 30. Oktober. Ein Nachweis, was du wann erlaubt hast, ist jetzt billig und später nicht mehr zu rekonstruieren.
- Nimm Änderungen am 28. Oktober vor, nicht am 29. Metas eigene Seite bittet, „bis zu 24 Stunden einzuplanen, bis Änderungen an der
robots.txtwirksam werden, weil Crawler deren Inhalt bis zu 24 Stunden zwischenspeichern können“ – eine am Vortag geänderte Datei gilt also womöglich noch nicht, wenn die Bedingungen gelten. - Geh nicht davon aus, dass Sperren die Sache erledigt. Im dokumentierten Bestand ist ein
Disalloweine technische Präferenz und die Klausel eine vertragliche Erlaubnis, und keine veröffentlichte Quelle sagt, dass Ersteres Letzteres zurücknimmt.
Wo die Branche wirklich uneins ist
Ob eine vertragliche Einräumung ändert, was robots.txt bewirkt. Das eine Lager sagt: Ein Crawler, der ein Disallow beachtet, nimmt den Inhalt nicht mit, was auch immer ein Vertrag erlaubt – und Meta selbst verweist immer wieder auf die Datei. Das andere sagt: Eine erteilte Erlaubnis wird durch eine geäußerte Präferenz nicht aufgehoben, und die von Nieman Lab befragten Juristen sagen, der Wortlaut eröffne Meta genau dieses Argument. Kein Gericht hat über diese Klausel entschieden, und Meta hat nichts veröffentlicht, was die beiden Dokumente in Einklang bringt.
Ob das Sperren eines Mehrzweck-Tokens den Zweck verweigert, der dich stört. Das eine Lager sagt, das Token sei die einzige Granularität, die der Standard anbietet, eine Sperre verweigere also alles, was es tut. Das andere sagt, zur Aufgabe der Indexierung gezwungen zu werden, um das Training zu verweigern, sei ein Bündel und keine Zustimmung – und eine Verweigerung allein des Trainings stehe gar nicht zur Verfügung. Messungen gibt es in keiner Richtung.
Ob Websites KI-Crawler überhaupt sperren sollten. Dieses Angebot hat dazu keine Position und bezieht hier keine. Cloudflare Radars Auswertung von rund 4.000 robots.txt-Dateien (31. August 2026) fand, dass Trainings-Bots zwei- bis dreimal häufiger gesperrt als erlaubt werden, während Antwort-Bots per saldo erlaubt bleiben: Das beschreibt, was Publisher tun, nicht ob sie richtigliegen – und die Zitatseite dieser Abwägung ist die Stelle, an der sich der Preis zeigt.
Ob die Verhaltensbeschreibung eines Managers ein Beleg für dieses Verhalten ist. Stone sagt, an Metas Crawler-Einsatz ändere sich nichts: eine Aussage über das Verhalten der Partei, die sie trifft, auf einer Plattform, die dieses Angebot nicht direkt lesen kann – und Meta veröffentlicht kein Crawler-Änderungsprotokoll, an dem sie sich prüfen ließe. Die verwandte Frage, die auf jeder agentischen Oberfläche offen ist: ob ein auf Nutzerwunsch ausgeführter Abruf überhaupt der robots.txt unterliegen sollte. Meta dokumentiert meta-externalfetcher als fähig, sie zu umgehen, und niemand hat gemessen, was ein solcher Abruf tatsächlich sendet.
Was ich denke
Ich verteidige genau eine Aussage: Die beiden Meta-Dokumente, die das regeln, treffen sich nicht. Die Commercial Terms erlauben automatisierte Erfassung und Training und nennen in beiden verfügbaren Wiedergaben robots.txt nicht. Die Crawler-Dokumentation bietet robots.txt als Steuerung an und nennt – geprüft bei einem Live-Abruf am 17. Oktober 2026 – keine Bedingungen, keinen Vertrag und kein Datum aus 2026. Metas Sprecher und sein Kommunikationschef verweisen Seitenbetreiber auf eine Datei, die das maßgebliche Dokument nicht erwähnt. Das kann jeder in fünf Minuten nachprüfen.
Was ich nicht sage, ist, ob du etwas verloren hast. Ich weiß nicht, ob ein Gericht die Klausel für durchsetzbar hielte; einer der drei Juristen sagte ausdrücklich, das sei unklar. Ich werde dir nicht sagen, Sperren sei zwecklos, denn keine Quelle sagt, die Einräumung schlage die Datei – und auch nicht, Sperren genüge, denn keine Quelle sagt, es nehme die Einräumung zurück. Beide Sätze werden diese Woche von Leuten geschrieben, die weder das eine noch das andere wissen. Die ehrliche Lesart ist langweiliger als die Schlagzeilen: Eine Entscheidung, die die meisten Seitenbetreiber vor sich herschoben, hat jetzt ein Datum, und die verfügbaren Kontrollen sind gröber als die erteilte Erlaubnis. Das sind zwei Stunden in irgendjemandes Woche wert und keine Krise.
Was weiterhin unbekannt ist
Ob die Klausel durchsetzbar ist. Ob „mit deinen Produkten oder Leistungen verbunden“ eine ganze Domain erfasst oder nur Produktseiten – PPC Land weist darauf hin, dass die Bedingungen das nicht definieren. Ob die Testzugänge Bezahlschranken umgehen würden; Meta beantwortete das nicht. Wie viele Websites betroffen sind: Dazu hat niemand eine Zahl veröffentlicht. Und ob sich am Crawler-Verhalten überhaupt etwas ändert, was Meta bestreitet und was keine außenstehende Partei messen kann.
Quellen
- Meta, Commercial Terms, gültig ab 30. Oktober 2026. Die Seite untersagt den automatisierten Abruf und war in diesem Lauf nicht lesbar; zitiert über die beiden folgenden Wiedergaben.
- Meta, Entwicklerdokumentation Meta Web Crawlers. Live gelesen am 17. Oktober 2026; die Seite trägt kein Aktualisierungsdatum.
- Andrew Deck und Hanaa’ Tameez, „Meta’s new commercial terms will allow the scraping of news sites, legal experts say“, Nieman Lab, 15. Oktober 2026.
- Luis Rijo, „Meta’s new terms let it crawl business websites to train AI from Oct 30“, PPC Land, 16. Oktober 2026.
- Luis Rijo, „Meta grants itself the right to crawl advertisers’ websites for AI“, PPC Land, 17. Oktober 2026.
- Matt G. Southern, „Meta’s New Terms Expand Crawling Rights Beyond Advertisers“, Search Engine Journal, 16. Oktober 2026.
- Andy Stone, Beitrag auf X, 16. Oktober 2026. In dieser Umgebung nicht abrufbar; zitiert nach der Wiedergabe von PPC Land vom 16. Oktober 2026.
- Cloudflare Radar, robots.txt-Auswertung von rund 4.000 Domains, 31. August 2026.