SparkToro hat am 17. November 2026 eine Auswertung von 41.961 ChatGPT-Konversationen veröffentlicht, die etwas tut, worum die Debatte über KI-Suche seit zwei Jahren herumredet: Sie beziffert, wie viel ChatGPT-Nutzung kommerziell ist, nennt das Panel, aus dem die Zahl stammt, veröffentlicht den Zeitraum und widmet danach einen ganzen Abschnitt dem, was das Panel nicht sehen kann.
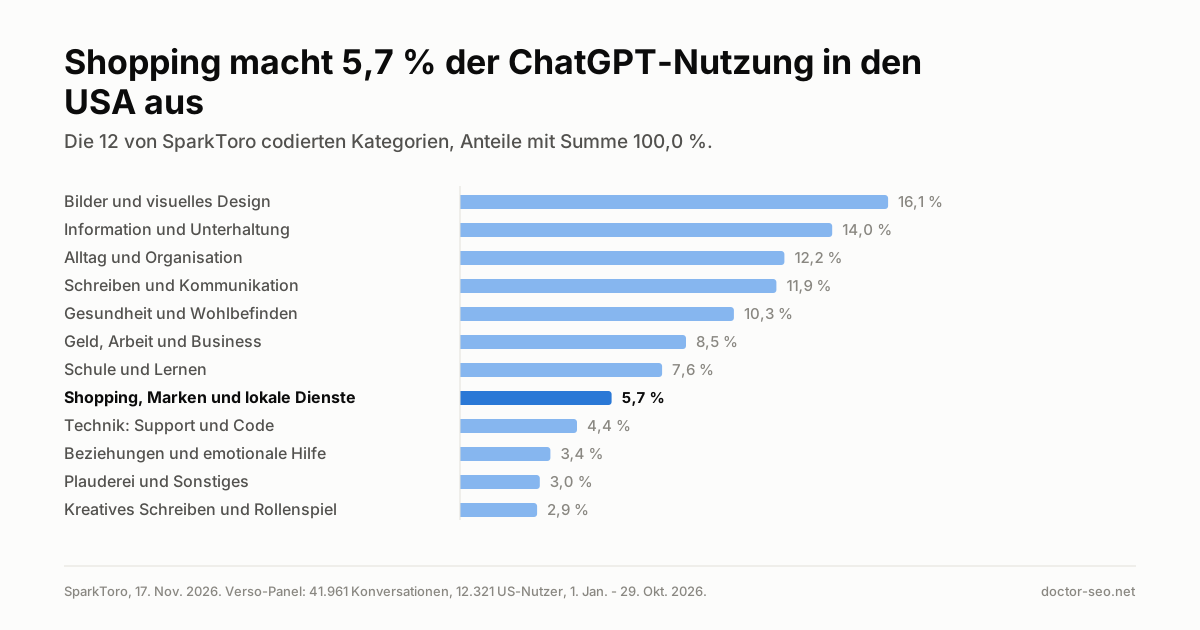
Die Zahl, die für jeden zählt, der etwas verkauft, ist klein. „Shopping, Marken und lokale Dienste“ macht 5,7 % der US-amerikanischen ChatGPT-Nutzung aus — Platz acht von zwölf Kategorien, hinter Gesundheit, hinter Lernen, hinter Alltagsorganisation.
Die Zahl, die das verkompliziert: Derselbe Beitrag nennt den kommerziellen Anteil zweimal, in zwei verschiedenen Einheiten, und löst den Widerspruch an keiner Stelle der Seite auf. Genau diese Lücke ist das Nützlichste an der Studie, und sie ist das, was die Fachpresse weggelassen hat.
Was SparkToro gemessen hat
SparkToro ist das von Rand Fishkin geführte Unternehmen für Audience Research, und die Daten dieser Studie stammen von Verso, das laut Beitrag „opt-in, anonymized connections to OpenAI“ herstellt. Der Datensatz umfasst 118.163 Prompts in 41.961 vollständigen, anonymisierten ChatGPT-Konversationen von 12.321 Panel-Nutzern, zwischen dem 1. Januar und dem 29. Oktober 2026, alle in den USA.
Jede Konversation erhielt genau ein Label aus einem Codebuch von 34 feingliedrigen Intentionen, gruppiert in zwölf Oberkategorien. Diese zwölf Kategorien summieren sich als Anteil pro Nutzer auf 100,0 %.
Lesenswert ist die Reihenfolge, nicht die Überschrift. Die drei größten Kategorien — Bilder und visuelles Design mit 16,1 %, Information und Unterhaltung mit 14,0 %, Alltag und Organisation mit 12,2 % — machen zusammen 42,3 % der Nutzung aus, und keine davon ist Suchverhalten in einem Sinn, den die Suchmaschinenoptimierung wiedererkennen würde. Das Häufigste, was Amerikaner in diesem Panel mit ChatGPT tun, ist Bilder erzeugen.
Die Methodik, die über dem Branchenstandard liegt
SparkToro hat mehr Methode offengelegt als fast jede kursierende Zahl zur KI-Nutzung, und diese Offenlegung macht die Studie zitierfähig. Was dokumentiert ist:
| Was offengelegt wird | Was der Beitrag sagt |
|---|---|
| Datenquelle | Verso, ein freiwilliges Panel von US-ChatGPT-Nutzern, die der Weitergabe ihres Verlaufs zugestimmt haben |
| Stichprobe | 41.961 Konversationen, 118.163 Prompts, 12.321 Nutzer |
| Zeitraum | 1. Januar bis 29. Oktober 2026 |
| Klassifikation | Codebuch mit 34 Intentionen in 12 Kategorien; jede Konversation von einem KI-Modell gelabelt, und der Beitrag hält fest: „Labels were not assigned by keyword rules“ |
| Übereinstimmungsprüfung | Ein zweiter, unabhängiger Codierer labelte eine Zufallsstichprobe erneut. Beide „agreed on 90% of category labels (κ ≈ 0,88) and on 97–99% of the brand tags“ |
| Gewichtung | Die 9.675 Panelisten mit demografischem Datensatz wurden auf die Zielwerte des US-Zensus 2024 für Alter, Geschlecht, Region, Bildung und Haushaltseinkommen gewichtet. „No category moved by more than 1,4 percentage points“ |
| Ausschlüsse | 131 Intensivnutzer, rund 1 % des Panels, die 21 % aller Prompts sendeten |
| Genannte Grenzen | Das Panel „skews younger, female, and lower-income“; es wurde überwiegend auf Mobilgeräten erfasst, sodass Desktop- und Arbeitskonten unterrepräsentiert sind; API-Verkehr fehlt vollständig |
| Fehlermarge | Nicht veröffentlicht. Die Begriffe „margin of error“ und „Konfidenzintervall“ kommen auf der Seite nicht vor |
Die letzte Zeile ist wichtig: Ein κ von 0,88 ist ein Maß für die Übereinstimmung zwischen Codierern, kein Stichprobenfehler, und wer solche Studien zitiert, verwechselt beides regelmäßig. SparkToro veröffentlicht das eine und nicht das andere.
Fishkin benennt auch die größte Lücke selbst. Das Panel „tells us what people ask ChatGPT far better than how much they use it“, weil API-Anfragen für es unsichtbar sind — und seine eigene Schätzung, wie viel dadurch verborgen bleibt, lautet „50-75% of all usage“, ausdrücklich als Vermutung und nicht als Messung.
Die zwei kommerziellen Zahlen, die nicht zusammenpassen
Das ist Kritik an einer konkreten Seite, nicht an SparkToro insgesamt. Der Beitrag nennt zwei verschiedene Werte dafür, wie viel ChatGPT-Nutzung kommerziell ist, und stellt sie nirgends nebeneinander.
Im Abschnitt „What percent of conversations have purchase intent?“ heißt es: „Only 6.9% of prompts showed anything related to researching a potential brand to buy from.“ In der Liste „Rand’s Takeaways“ gegen Ende lautet Punkt drei: „That said, 12% of ChatGPT usage is part of the buyer journey.“
Das sind nicht dieselben Aussagen. Die eine ist ein Anteil an Prompts, die andere an der Nutzung; die eine beschränkt sich auf die Recherche zu einer Marke, bei der man kaufen will, die andere umfasst die gesamte Buyer Journey. In zwei unabhängigen Lesungen am 20. November 2026 bestätigt: Der Beitrag enthält keinen Satz, der beide auflöst, und keine Erklärung, welche Definition die 12 % verwenden. Der Abschnitt zur Kaufabsicht definiert drei Gruppen — keine Kaufabsicht, Optionen recherchieren, eine einzelne Marke prüfen — ohne zu sagen, welche davon die 12 % zusammenfassen.
Eine dritte Zahl steht daneben und ist wieder etwas anderes: 12,1 % der Antworten enthielten eine oder mehrere Marken, Produkte oder Unternehmen. Das ist eine Eigenschaft der Antworten von ChatGPT, nicht der Absicht der Nutzer, und es ist die Zahl, die am leichtesten mit den anderen beiden verwechselt wird, weil sie einer davon zahlenmäßig fast gleicht.
Die praktische Folge ist einfach: Wer einen kommerziellen Anteilswert für ChatGPT zitiert, muss sagen, welchen der drei und in welcher Einheit — denn die Quelle tut es nicht.
Der Google-Vergleich und die Rechnung, die der Beitrag nicht zeigt
SparkToro stellt den ChatGPT-Wert der eigenen früheren Arbeit zu Google gegenüber: „For comparison, when we looked at 332 million Google queries two years ago, 15%+ matched this definition.“ Nach den beiden im Beitrag veröffentlichten Zahlen ist der kommerzielle Anteil der Google-Suchanfragen also ungefähr doppelt so hoch wie der der ChatGPT-Prompts.
Der Beitrag beschreibt den Abstand dann als größer. Google sei „~2.8X bigger (probably more) in the percent of searches with purchase intent“, und „Conservatively, I’d guess that people ask Google purchase-journey-related queries at 16X+ the rate of ChatGPT.“
Die Division der beiden veröffentlichten Werte ergibt rund 2,2, nicht 2,8. Der Unterschied lässt sich womöglich vollständig damit erklären, dass 15 %+ eine Untergrenze und kein Punktwert ist und dass die Google-Auswertung zwei Jahre älter ist und vielleicht keine identische Definition verwendet — aber der Beitrag zeigt für keines der beiden Verhältnisse eine Rechnung, und den Faktor 16 kennzeichnet der Autor selbst als Vermutung. Die 5,7 % und die 6,9 % sind die Befunde der Studie, die Multiplikatoren sind Kommentar dazu.
Was sich dadurch in der Praxis ändert
Weniger, als die Überschrift nahelegt, und in eine bestimmte Richtung. Ein Shopping-Anteil von 5,7 % ist eine Aussage über Zusammensetzung, nicht über Volumen: Er sagt, woraus das Segment besteht, nicht wie viele Menschen darin sind. Ein kleiner Anteil eines großen Produkts kann immer noch eine relevante Zahl von Käufern bedeuten, und die Studie beziffert das bewusst nicht, weil ihr Autor sagt, das Panel könne Nutzungsvolumen nicht messen.
Was sie stützt, ist eine Neugewichtung des Aufwands. Wenn rund neun von zehn ChatGPT-Konversationen überhaupt nicht kommerziell sind, misst ein Werkzeug, das den Anteil Ihrer Marke an einem Prompt-Set ausweist, einen schmalen Streifen der Oberfläche — und diesen Anteil als Nachfragesignal zu lesen, ist ein Kategorienfehler. Unsere Lektion dazu, warum jede KI Suchvolumina erfindet, zeigt denselben Fehler in Reinform.
Was diese Woche zu tun ist
- Notieren Sie, welche der drei Zahlen Sie bisher zitiert haben — 5,7 % der Nutzung, 6,9 % der Prompts oder 12,1 % der Antworten — und korrigieren Sie die Einheit in jedem Report und jeder Präsentation, in der sie steht.
- Trennen Sie KI-Referral-Sitzungen vom KI-Sichtbarkeitsanteil im Reporting. Sie beantworten verschiedene Fragen und bewegen sich unabhängig voneinander; beide in einem Diagramm zu führen ist der Weg, auf dem ein Anstieg der Zitierungen als Nachfrage präsentiert wird.
- Exportieren Sie jetzt eine datierte Basislinie Ihrer Impressionen in KI-Funktionen, damit das, was Sie in sechs Monaten schließen, einen Startpunkt hat, den Sie nicht rekonstruieren mussten. Die Methode steht im Kursniveau SEO-Analytics und Messung.
- Prüfen Sie, ob Ihre Branche überhaupt in diesen 5,7 % steckt. Ein B2B-Softwareanbieter und ein örtlicher Installateur sind beide „kommerziell“ und haben innerhalb einer so groben Kategorie mit ziemlicher Sicherheit unterschiedliche Anteile.
- Zahlen Sie nicht mehr für Sichtbarkeitsberichte, die ihr Prompt-Set nicht veröffentlichen. Ein Sichtbarkeitsprozentsatz bezieht sich auf eine Stichprobe, die jemand ausgewählt hat; wird sie nicht offengelegt, ist der Prozentsatz keine Populationsgröße.
Wo die Branche wirklich uneins ist
Diese Studie landet mitten in einer Auseinandersetzung, die dieses Blog nicht für entschieden hält — und hier wird sie auch nicht entschieden.
Kann ein freiwilliges Verbraucher-Panel sagen, welcher Anteil des kommerziellen Suchverhaltens zu KI-Assistenten gewandert ist? Das eine Lager sagt ja, innerhalb der genannten Grenzen: 41.961 vollständige Konversationen sind für dieses Feld eine große Stichprobe, die Gewichtung verschob keine Kategorie um mehr als 1,4 Punkte, die Klassifikationsübereinstimmung wurde unabhängig geprüft, und eine Studie, die ihre eigenen Lücken veröffentlicht, ist mehr wert als eine Anbietergrafik, die gar keine nennt. Das andere sagt, das Instrument sehe einen einzigen Streifen eines einzigen Produkts — Consumer, mobil, ohne API, freiwillig — und die fehlenden Streifen seien genau dort, wo sich kommerzielle und berufliche Nutzung konzentrieren würde; ein daraus gewonnener Zusammensetzungswert lasse sich deshalb nicht als Populationsanteil lesen. Niemand hat ein Panel mit API-Verkehr veröffentlicht und auch keine gepaarte Messung von Consumer- und Desktop-Nutzung, also argumentieren beide Lager aus demselben einzigen Datensatz.
Verwandt und auf dieser Seite ebenso offen: ob plattforminterne Substitutionsdaten auf ein anderes Produkt übertragbar sind, ob Experimente mit erzwungener Adoption sich auf schrittweise Adoption verallgemeinern lassen, und ob eine modellierte Volumenzahl eine Messung ist oder eine als Zählung präsentierte Schätzung. Unser Kursniveau GEO und AIO markiert jede davon als offen, statt sie aufzulösen.
Was ich davon halte — Txema Hermoso
Dieser Abschnitt ist Meinung; alles davor ist es nicht.
Die wertvollste Zahl dieser Studie sind nicht die 5,7 %. Es ist der Umstand, dass eine sorgfältig codierte Auswertung, von jemandem mit allen Anreizen zu einer sauberen Schlagzeile, zwei nicht aufgelöste Werte für den kommerziellen Anteil in einem Beitrag veröffentlicht hat. Das ist kein Skandal, sondern das Aussehen ehrlicher Messung, wenn niemand so tut, als wäre die Sache ordentlich. Studien, die mit einer einzigen sauberen Zahl zurückkommen, haben meist weniger gemessen.
Der Befund zur Zusammensetzung wird außerdem rückwärts gelesen. „Nur 5,7 % sind Shopping“ kursiert als Beleg dafür, dass KI-Suche kommerziell egal sei. Er belegt etwas Engeres und Nützlicheres: Der kommerzielle Streifen ist klein genug, dass ein Sichtbarkeitswert über ein beliebiges Prompt-Set als Nachfragesignal nahezu wertlos ist. Das sind verschiedene Aussagen, und die zweite ist diese Woche umsetzbar, während die erste eine Parole ist.
Was ich Ihnen nicht sage, ist, ob Sie Budget aus der KI-Sichtbarkeitsarbeit abziehen sollen. Die Studie misst kein Volumen, ihr Autor schreibt das selbst, und ich werde aus einem Zusammensetzungsprozentsatz keine Budgetempfehlung machen, die die Daten nicht tragen.
Was weiterhin unbekannt ist
- Wie viel Nutzung dem Panel entgeht. Fishkins „50-75%“ für API-Verkehr ist seine eigene Schätzung und als solche gekennzeichnet. Eine veröffentlichte Zahl gibt es nicht.
- Ob die 12 % und die 6,9 % dieselbe Grundgesamtheit beschreiben. Der Beitrag sagt es nicht, und bis Redaktionsschluss war keine Korrektur veröffentlicht.
- Wie der Shopping-Anteil nach Branche oder Warenkorbgröße aussieht. Die Aufteilung in zwölf Kategorien ist zu grob, um einen lokalen Dienst von einem überlegten Kauf zu trennen.
- Ob sich davon etwas bewegt. Die Daten decken zehn Monate als einen einzigen Block ab; der Beitrag veröffentlicht keine Zeitreihe darüber.
- Wie oft ChatGPT nach außen verlinkt. Der Beitrag enthält keine Zahl dazu, wie oft Antworten eine Website zitieren oder verlinken — in zwei Lesungen bestätigt. Die 12,1 % Markennennungen sind diese Zahl nicht.
Quellen
- SparkToro, „We Analyzed 118,000 ChatGPT Prompts from 12,000+ Users to Answer: How Do Americans Use AI Tools in 2026?“, Rand Fishkin, 17. November 2026. Am 20. November 2026 von unabhängigen Agenten zweimal gelesen; alle Zitate oben stammen von dieser Seite.
- Verso, der im Beitrag genannte Panel-Anbieter. Eine unabhängige Prüfung des Panels gibt es nicht.
- Google Search Status Dashboard, Störungsmeldungen, abgerufen am 20. November 2026: Das Core Update vom November 2026, begonnen am 2026-11-10, ist weiterhin der einzige Vorgang ohne Endzeitstempel. Keine Aussage in diesem Beitrag wird ihm zugeschrieben.