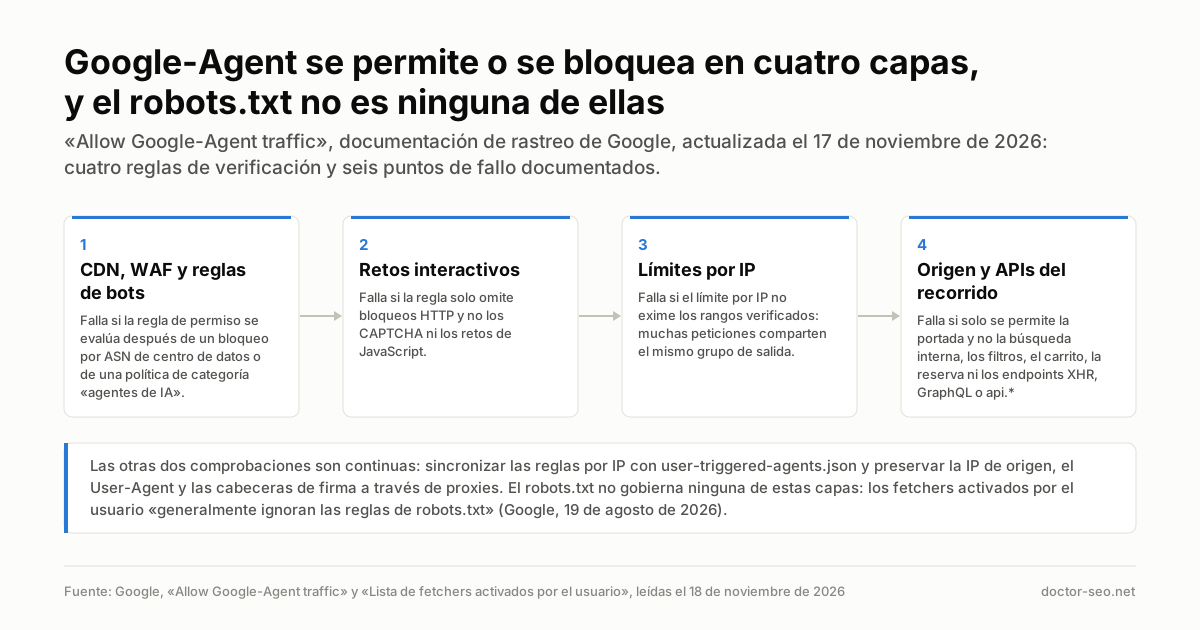
El 17 de noviembre de 2026 Google publicó una página nueva en su documentación de rastreo: «Allow Google-Agent traffic». No explica cómo bloquear a su agente. Explica cómo asegurarse de que pasa.
Google-Agent no es nuevo: el registro de ese user agent aparece en el changelog de rastreo desde el 20 de marzo de 2026. Lo nuevo es la guía, y lo que la hace relevante para cualquiera que administre un sitio es dónde dice que se toma la decisión. La página está escrita para el CDN, el cortafuegos de aplicación (WAF) y el servicio de detección de bots. El robots.txt no aparece en el cuerpo del documento ni una sola vez.
Eso no es un descuido de redacción. Es la consecuencia de una clasificación que Google ya tenía documentada, y que esta guía hace operativa.
Qué publicó Google, exactamente
La página tiene tres secciones: cómo identifica Google-Agent sus peticiones, cómo permitirlas en el CDN, el cortafuegos o el detector de bots, y una sección de resolución de problemas. Lleva la marca Last updated 2026-11-17 UTC, leída en dos comprobaciones independientes el 18 de noviembre de 2026.
Google define al agente así: Google-Agent is the name used by agents hosted on Google infrastructure to navigate the web and perform actions upon user request
. Y declara el propósito de la guía: Explicitly allowing Google-Agent traffic … helps prevent legitimate requests from being blocked while preserving your existing security controls
.
El changelog de rastreo registra la publicación con una entrada del 17 de noviembre titulada Added guidance on allowing Google-Agent
, cuyo cuerpo dice: Published a technical guide on how to ensure that Google-Agent has access to your website
, y como motivo, To help publishers that want to enable Google-Agent for their website
.
La pieza que cambia el encuadre está en otra página. La lista de fetchers activados por el usuario, con marca Last updated 2026-08-19 UTC, dice de esta familia completa: Because the fetch was requested by a user, these fetchers generally ignore robots.txt rules
. Si el agente ignora el robots.txt, entonces permitirlo o no permitirlo es una decisión que se ejecuta en la capa de red, no en un fichero de texto. La guía del 17 de noviembre es el manual de esa capa.
Las cuatro reglas de verificación
Google dice primero que algunos servicios ya hacen la verificación solos: Some bot-detection services, CDNs, and Firewalls provide ways to verify requests made by the Google-Agent user agent
, y remite a cada proveedor para los pasos concretos. Para quien no tenga esa opción automática, la guía da cuatro reglas manuales:
Confirm the User-Agent header contains Google-Agent.
Confirm the IP address as being in user-triggered-agents.json.
If provided, confirm the signed request by verifying the Signature and Signature-Input headers…
, contra el valorSignature-Agentde la identidadhttps://agent.bot.goog.For verified requests, skip bot challenges.
La tercera regla es la más nueva. Google firma parte de sus peticiones con el estándar de firmas HTTP (RFC 9421) y publica su juego de claves en https://agent.bot.goog/.well-known/http-message-signatures-directory. La propia página lo califica de experimental: Google is also experimenting with the Web Bot Auth protocol using the https://agent.bot.goog identity
.
El orden de las reglas importa más de lo que parece. La lista de fetchers advierte, con la palabra Caution: The user agent string can be spoofed
. Permitir por cadena de user agent y nada más es abrir la puerta a cualquiera que la copie. La verificación real es la IP, o la firma.
Comprobamos el fichero de rangos el 18 de noviembre de 2026: user-triggered-agents.json declaraba creationTime: 2026-11-17T15:45:49 y contenía 20 prefijos: 12 IPv4 y 8 IPv6. PPC Land, el día anterior, informó del mismo fichero con 20 prefijos y la misma repartición, generado el 16 de noviembre a las 15:45. Son dos observaciones fechadas con 24 horas de diferencia y el mismo minuto de reloj, con fechas de generación distintas. No es una medición de frecuencia, pero sí es la razón por la que copiar esos rangos a mano envejece mal.
Los seis puntos donde la petición sigue muriendo
La sección de resolución de problemas empieza con una frase que reconoce el caso real: If legitimate Google-Agent requests are still blocked after allowing these requests
. Siguen seis comprobaciones, y leídas juntas son un mapa de por dónde se cae una petición en una pila moderna:
- Prioridad de la regla.
Confirm that your allow rule has higher priority than (and evaluates before) broad cloud or data center ASN blocks
, además de las reglas gestionadas de bots y de las políticas de categoría que bloquean agentes de IA. - Retos interactivos.
Confirm that your rule skips interactive CAPTCHAs and JavaScript challenges in addition to HTTP blocks
, incluidos los widgets de CAPTCHA que saltan al buscar o al enviar un formulario. - Acciones dentro del recorrido y APIs.
Confirm that allowing these requests covers actions beyond initial homepage loads
: búsqueda interna, filtros, fichas de producto, añadir al carrito, reservar, y los endpoints XHR, GraphQL oapi.*que hay debajo. - Límites por IP compartida.
Confirm that per-IP rate-limiting rules account for or exempt verified Google-Agent IP ranges
, porque las peticiones concurrentes de muchos usuarios comparten el mismo grupo de salida. - Actualización de rangos.
Confirm that IP-based rules stay synced with the latest ranges in user-triggered-agents.json.
- Cabeceras en proxies.
Confirm that load balancers and intermediate proxies preserve the original client IP, the User-Agent header
, y, en peticiones firmadas, las cabecerasSignature,Signature-InputySignature-Agent.
El primer punto es el que más dice. Google está documentando que existen políticas de categoría que bloquean agentes de IA por defecto en productos de gestión de bots, y que esas políticas pueden ganar a una regla de permiso del propietario del sitio. Es Google reconociendo que, en muchos sitios, esta decisión ya está tomada por un tercero.
Lo que el documento no dice
Tan verificable como lo que la página contiene es lo que no contiene. Estas ausencias se comprobaron en dos lecturas independientes el 18 de noviembre de 2026.
| Documento | Marca de fecha | Qué aporta sobre Google-Agent |
|---|---|---|
| «Allow Google-Agent traffic» | Last updated 2026-11-17 UTC | Cuatro reglas de verificación y seis comprobaciones. Sin robots.txt, sin consecuencias, sin productos citados. |
| Lista de fetchers activados por el usuario | Last updated 2026-08-19 UTC | Qué es el agente, sus cadenas de user agent, el fichero de IP, y la frase sobre ignorar el robots.txt. |
| Changelog de rastreo | Last updated 2026-11-17 UTC | La única entrada que registra la guía. |
| Changelog de Search Central | Entrada más reciente: 12 de noviembre | Ninguna entrada del 17 de noviembre y ninguna aparición de «Google-Agent». |
| Blog de Search Central | Entrada más reciente: 16 de noviembre | Nada sobre la guía. |
user-triggered-agents.json |
creationTime 2026-11-17T15:45:49 | 20 prefijos: 12 IPv4 y 8 IPv6. |
Tres ausencias concretas, todas verificadas con una pregunta explícita de sí o no en la segunda lectura:
El robots.txt no aparece en el cuerpo de la guía. Solo figura en la navegación lateral, como enlace a otra página. No hay ninguna frase que compare a Google-Agent con Googlebot en ese punto, ni que diga si lo obedece o no. La respuesta está en la otra página, la de agosto, y es que estos fetchers generalmente no lo obedecen.
No hay consecuencias documentadas. La página no dice qué gana un sitio por permitir el agente ni qué pierde por bloquearlo. No menciona posicionamiento, visibilidad en funciones de IA, ni ningún efecto. Lo más cercano es la frase de propósito ya citada, que describe el beneficio de permitir, no el coste de no hacerlo.
No se nombra ningún producto de Google. La guía habla de agents hosted on Google infrastructure
y nada más. No dice qué funciones usan Google-Agent para actuar en nombre de un usuario.
Qué cambia en la práctica
Para un responsable de SEO cambia a quién hay que preguntarle. Durante quince años la respuesta a «¿dejamos entrar a este bot?» vivía en un fichero que el equipo de SEO podía editar. Para esta familia de peticiones no vive ahí. Vive en la consola del CDN, en las reglas gestionadas del WAF y en los valores por defecto del detector de bots, que normalmente administra otro equipo y a veces otra empresa.
Cambia también qué significa «ya lo permitimos». La lista de seis puntos describe seis maneras de haberlo permitido y seguir bloqueándolo: con la regla en el sitio equivocado del orden de evaluación, cubriendo solo bloqueos HTTP, cubriendo solo la portada, con un límite por IP sin excepción, con unos rangos copiados hace semanas, o con un proxy que borra la cabecera que identifica al agente. Ninguna de las seis se ve desde el robots.txt, y ninguna se ve desde Search Console.
Si estás revisando reglas de rastreadores este mes, el validador de robots.txt sigue siendo la herramienta correcta para Googlebot y para los rastreadores de IA que sí lo obedecen. Para Google-Agent no lo es, y esa distinción es la misma que explicamos en los tres bots de Claude y tu robots.txt: un mismo proveedor puede tener varios agentes con reglas de obediencia distintas, y tratarlos como uno solo es el error más común.
Qué hacer esta semana
Siete pasos, todos ejecutables con lo que ya tienes:
- Busca el token. Filtra los registros de tu CDN o de tu origen por la cadena
Google-Agenten los últimos 30 días. Anota el número de peticiones y los códigos de estado devueltos. - Mira los códigos, no el total. Si aparecen 403, 429 o respuestas de reto, ya tienes la respuesta: el agente llega y no pasa.
- Verifica antes de permitir. No permitas solo por cadena de user agent: Google avisa de que se puede falsificar. Contrasta la IP contra
user-triggered-agents.json. - Automatiza el fichero de rangos. Descárgalo de forma programada y compara su
creationTime. Una lista copiada a mano puede quedarse desfasada en un día. - Revisa el orden de evaluación. Comprueba que tu regla de permiso se evalúa antes que los bloqueos por ASN de centro de datos y que cualquier política de categoría de agentes de IA que traiga tu proveedor por defecto.
- Prueba más allá de la portada. Repite la prueba sobre la búsqueda interna, un listado filtrado, una ficha, el carrito y los endpoints XHR o GraphQL que hay detrás. Es el punto que la guía señala y el que casi nadie comprueba.
- Deja constancia de la decisión y su fecha. Permitir o bloquear son las dos opciones legítimas. Lo que no es defendible es no saber cuál tienes activa.
Este es trabajo de SEO técnico en el sentido literal: se hace en la capa de red y se comprueba en los registros.
Dónde la industria discrepa de verdad
Cuatro desacuerdos reales que este documento toca y que no resuelve. Ninguno se cierra aquí.
Si conviene o no bloquear a los agentes de IA. Un campo sostiene que un agente que actúa por encargo de un usuario es tráfico de usuario y bloquearlo es perder a ese usuario. El otro sostiene que un sitio que no puede medir ni limitar un tráfico automatizado no debería aceptarlo por defecto. Nadie ha publicado una comparación de ingresos entre sitios que permiten y sitios que bloquean, así que ambos argumentan desde principios.
Si una instrucción permanente sigue siendo «activada por el usuario». La categoría de Google exime del robots.txt porque la petición la pidió una persona. Qué ocurre cuando esa persona pide algo una vez y el agente actúa durante días es una pregunta que la documentación de Google no responde, y de la que depende si el robots.txt es una herramienta válida aquí.
Si un cambio de documentación dice algo sobre los sistemas de Google. Un campo lee una página fechada como la nota de versión más fiable que publica Google. El otro responde que Google publica guía para propietarios de sitios, no especificaciones, y que las dos cosas se han separado muchas veces. Google no publica ninguna correspondencia entre una edición de documentación y un cambio en producción, así que el ritmo al que una acompaña a la otra es desconocido.
Y una pregunta que este documento abre. Cuando un agente ignora el robots.txt y la decisión se ejecuta en el CDN, ¿sigue teniendo el editor esa decisión, o la ha delegado sin saberlo en el valor por defecto de su proveedor de gestión de bots? La propia guía de Google da por supuesto que existen políticas de categoría que bloquean agentes de IA y que hay que ganarles en prioridad. Eso describe un sitio cuya política de acceso la escribió un tercero. Queda anotada en nuestro registro de temas en disputa, sin veredicto.
La opinión del autor
Lo que defiendo de este documento es lo documental, y nada más.
Me parece el cambio de documentación más útil que Google ha publicado este mes, y no por lo que enseña a configurar, sino por lo que admite. Los seis puntos de la sección de problemas no son teoría: son la lista de cosas que, por experiencia de cualquiera que haya administrado un WAF, fallan de verdad. Que Google haya tenido que escribirlas sugiere que recibe el reporte a menudo.
No voy a decir que esto anticipe un cambio de posicionamiento. Google no publicó ninguna medición, no nombró ninguna función, no prometió ningún resultado y no cambió ninguna política, y no pienso rellenar ese hueco con un mecanismo inventado.
Tampoco voy a decirte si debes dejar entrar al agente. Esa decisión depende de cuánto valga para tu negocio un usuario que llega a través de un intermediario, y nadie ha publicado el número que la respondería. Lo que sí sostengo es más modesto y creo que más útil: la mayoría de los sitios no ha tomado esa decisión en absoluto, y hoy, por primera vez, hay un documento fechado que dice exactamente dónde se está tomando por ellos.
Lo que sigue sin saberse
Cuántos sitios bloquean hoy a Google-Agent. Google no lo publica. La prensa especializada cita cifras de proveedores de seguridad sobre bloqueo de agentes; no hemos leído esas fuentes primarias en esta comprobación, así que no las repetimos aquí.
Qué funciones de Google usan el agente. El documento dice «agentes alojados en la infraestructura de Google» y no concreta.
Qué pasa si lo bloqueas. No hay consecuencia documentada en ninguna de las dos páginas.
Cuándo deja de ser experimental la firma de peticiones. Google usa esa palabra y no da fecha.
Y con qué frecuencia cambia el fichero de rangos. Tenemos dos observaciones fechadas con valores distintos de creationTime en días consecutivos; eso no es una serie, y Google no publica la cadencia.
Fuentes
- Google, Allow Google-Agent traffic, documentación de rastreo, Last updated 2026-11-17 UTC. Leída dos veces el 18 de noviembre de 2026.
- Google, List of Google user-triggered fetchers, Last updated 2026-08-19 UTC. Leída el 18 de noviembre de 2026.
- Google, changelog de la infraestructura de rastreo, entrada del 17 de noviembre de 2026. Leído el 18 de noviembre de 2026.
- Google, changelog de documentación de Search Central, entrada más reciente del 12 de noviembre de 2026. Leído dos veces el 18 de noviembre de 2026.
- Google, user-triggered-agents.json, creationTime 2026-11-17T15:45:49. Leído el 18 de noviembre de 2026.
- Barry Schwartz, New Google Search Help Document On How To Allow Google-Agent Traffic, Search Engine Roundtable, 17 de noviembre de 2026.
- Luis Rijo, Google lists six ways sites still block its AI agent after allowing it, PPC Land, 17 de noviembre de 2026.
Ninguna de estas fuentes es un estudio, de modo que no hay tamaño de muestra que citar: son documentos fechados y dos informes de prensa especializada. Google no publicó ninguna medición junto a esta guía.