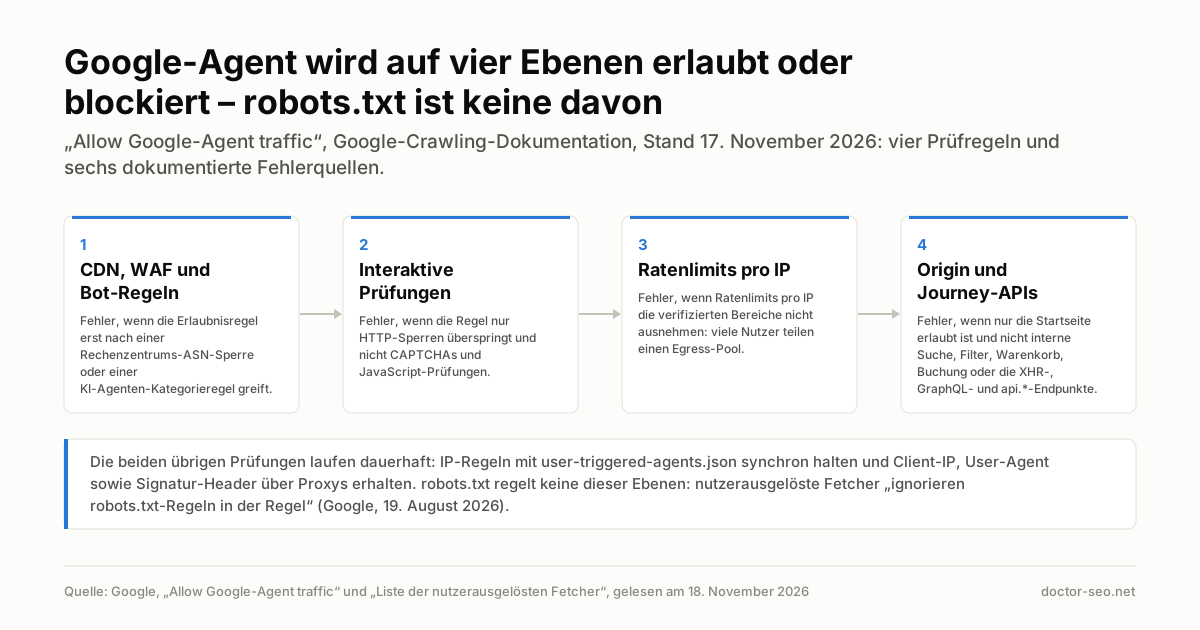
Am 17. November 2026 hat Google eine neue Seite in seiner Crawling-Dokumentation veröffentlicht: „Allow Google-Agent traffic“. Sie erklärt nicht, wie man Googles Agenten blockiert. Sie erklärt, wie man dafür sorgt, dass er durchkommt.
Google-Agent selbst ist nicht neu – der User Agent steht seit dem 20. März 2026 im Crawling-Changelog. Neu ist die Anleitung, und für jeden, der eine Website betreibt, ist daran vor allem eines interessant: wo laut Google die Entscheidung fällt. Die Seite ist für das Content Delivery Network, die Web Application Firewall und den Bot-Erkennungsdienst geschrieben. Im Fließtext des Dokuments taucht robots.txt kein einziges Mal auf.
Das ist kein redaktionelles Versehen. Es folgt aus einer Einordnung, die Google längst dokumentiert hatte – und diese Anleitung macht sie operativ.
Was Google genau veröffentlicht hat
Die Seite hat drei Abschnitte: wie Google-Agent seine Anfragen kenntlich macht, wie man diesen Verkehr im CDN, in der Firewall oder im Bot-Erkennungsdienst erlaubt, und eine Liste zur Fehlersuche. Sie trägt den Stempel Last updated 2026-11-17 UTC, bestätigt in zwei unabhängigen Abrufen am 18. November 2026.
Google definiert den Agenten so: Google-Agent is the name used by agents hosted on Google infrastructure to navigate the web and perform actions upon user request
. Den Zweck der Anleitung formuliert Google so: Explicitly allowing Google-Agent traffic … helps prevent legitimate requests from being blocked while preserving your existing security controls
.
Das Crawling-Changelog verzeichnet die Veröffentlichung mit einem Eintrag vom 17. November unter der Überschrift Added guidance on allowing Google-Agent
. Im Text heißt es: Published a technical guide on how to ensure that Google-Agent has access to your website
, als Begründung To help publishers that want to enable Google-Agent for their website
.
Der Satz, der die ganze Sache einordnet, steht auf einer anderen Seite. Die Liste der nutzerausgelösten Fetcher mit dem Stempel Last updated 2026-08-19 UTC sagt über diese gesamte Gruppe: Because the fetch was requested by a user, these fetchers generally ignore robots.txt rules
. Wenn der Agent robots.txt ignoriert, dann ist Erlauben oder Sperren eine Entscheidung, die auf der Netzwerkebene vollzogen wird und nicht in einer Textdatei. Die Anleitung vom 17. November ist das Handbuch für genau diese Ebene.
Die vier Prüfregeln
Googles erste Antwort lautet, dass manche Dienste die Prüfung bereits selbst erledigen: Some bot-detection services, CDNs, and Firewalls provide ways to verify requests made by the Google-Agent user agent
– für die genauen Schritte verweist Google auf den jeweiligen Anbieter. Wer diese automatische Option nicht hat, bekommt vier manuelle Regeln:
Confirm the User-Agent header contains Google-Agent.
Confirm the IP address as being in user-triggered-agents.json.
If provided, confirm the signed request by verifying the Signature and Signature-Input headers…
– gegen denSignature-Agent-Wert der Identitäthttps://agent.bot.goog.For verified requests, skip bot challenges.
Die dritte Regel ist der neueste Teil. Google signiert einen Teil seiner Agenten-Anfragen nach dem Standard für HTTP-Signaturen (RFC 9421) und veröffentlicht seinen Schlüsselsatz unter https://agent.bot.goog/.well-known/http-message-signatures-directory. Die Seite bezeichnet das ausdrücklich als unfertig: Google is also experimenting with the Web Bot Auth protocol using the https://agent.bot.goog identity
.
Die Reihenfolge dieser Regeln ist wichtiger, als sie aussieht. Die Fetcher-Liste enthält einen Warnhinweis: The user agent string can be spoofed
. Wer allein anhand der User-Agent-Zeichenkette erlaubt, öffnet jedem die Tür, der sie kopiert. Verifiziert wird über die IP-Bereiche oder über die Signatur.
Wir haben die Bereichsdatei am 18. November 2026 abgerufen: user-triggered-agents.json wies creationTime: 2026-11-17T15:45:49 aus und enthielt 20 Präfixe – 12 IPv4 und 8 IPv6. PPC Land beschrieb einen Tag zuvor dieselbe Datei mit 20 Präfixen in derselben Aufteilung, erzeugt am 16. November um 15:45 Uhr. Das sind zwei datierte Beobachtungen im Abstand von 24 Stunden, zur selben Uhrzeit, mit unterschiedlichen Erzeugungsdaten. Eine Messung der Taktung ist das nicht, wohl aber der Grund, warum eine von Hand kopierte Freigabeliste schlecht altert.
Die sechs Stellen, an denen die Anfrage trotzdem stirbt
Der Abschnitt zur Fehlersuche beginnt mit einem Satz, der den realen Fall einräumt: If legitimate Google-Agent requests are still blocked after allowing these requests
. Es folgen sechs Prüfungen, und zusammengelesen sind sie eine Landkarte dessen, woran eine Anfrage in einem modernen Stack scheitert:
- Regelpriorität.
Confirm that your allow rule has higher priority than (and evaluates before) broad cloud or data center ASN blocks
– ebenso vor verwalteten Bot-Regeln und vor Kategorieregeln, die KI-Agenten sperren. - Interaktive Prüfungen.
Confirm that your rule skips interactive CAPTCHAs and JavaScript challenges in addition to HTTP blocks
, einschließlich CAPTCHA-Widgets, die bei einer Suche oder beim Absenden eines Formulars ausgelöst werden. - Aktionen im Journey und APIs.
Confirm that allowing these requests covers actions beyond initial homepage loads
: interne Suche, Filter, Detailseiten, Warenkorb, Buchung sowie die darunterliegenden XHR-, GraphQL- oderapi.*-Endpunkte. - Ratenlimits bei geteilter IP.
Confirm that per-IP rate-limiting rules account for or exempt verified Google-Agent IP ranges
– weil gleichzeitige Anfragen vieler Nutzer denselben Egress-Pool teilen. - Aktualität der IP-Bereiche.
Confirm that IP-based rules stay synced with the latest ranges in user-triggered-agents.json.
- Header in Proxys.
Confirm that load balancers and intermediate proxies preserve the original client IP, the User-Agent header
– und bei signierten Anfragen die HeaderSignature,Signature-InputundSignature-Agent.
Der erste Punkt sagt am meisten aus. Google dokumentiert damit, dass es in Produkten zur Bot-Verwaltung Kategorieregeln gibt, die KI-Agenten standardmäßig sperren, und dass eine solche Regel die eigene Erlaubnisregel des Website-Betreibers überstimmen kann. Google räumt damit ein, dass diese Entscheidung auf vielen Websites bereits von einem Dritten getroffen wurde.
Was das Dokument nicht sagt
Was die Seite auslässt, ist genauso überprüfbar wie das, was sie enthält. Jede dieser Leerstellen wurde am 18. November 2026 in zwei unabhängigen Abrufen bestätigt.
| Dokument | Datumsstempel | Was es zu Google-Agent beiträgt |
|---|---|---|
| „Allow Google-Agent traffic“ | Last updated 2026-11-17 UTC | Vier Prüfregeln und sechs Prüfpunkte. Kein robots.txt, keine Folgen, keine genannten Produkte. |
| Liste der nutzerausgelösten Fetcher | Last updated 2026-08-19 UTC | Was der Agent ist, seine User-Agent-Zeichenketten, die IP-Datei und der Satz zum Ignorieren von robots.txt. |
| Crawling-Changelog | Last updated 2026-11-17 UTC | Der einzige Eintrag, der die Anleitung verzeichnet. |
| Search-Central-Dokumentations-Changelog | Neuester Eintrag: 12. November | Kein Eintrag vom 17. November und kein Vorkommen von „Google-Agent“. |
| Search-Central-Blog | Neuester Eintrag: 16. November | Nichts zu dieser Anleitung. |
user-triggered-agents.json |
creationTime 2026-11-17T15:45:49 | 20 Präfixe: 12 IPv4 und 8 IPv6. |
Drei konkrete Leerstellen, jede im zweiten Abruf mit einer ausdrücklichen Ja-Nein-Frage geprüft:
robots.txt steht nicht im Fließtext der Anleitung. Es erscheint nur in der seitlichen Navigation als Link auf eine andere Seite. Es gibt keinen Satz, der Google-Agent in diesem Punkt mit dem Googlebot vergleicht, und keinen, der sagt, ob der Agent die Datei befolgt. Die Antwort steht auf der August-Seite, und sie lautet, dass diese Fetcher sie in der Regel nicht befolgen.
Es sind keine Folgen dokumentiert. Die Seite sagt nicht, was eine Website gewinnt, wenn sie den Agenten zulässt, oder verliert, wenn sie ihn sperrt. Von Rankings, von Sichtbarkeit in KI-Funktionen oder von irgendeiner Wirkung ist nicht die Rede. Am nächsten kommt der oben zitierte Zwecksatz, und der beschreibt den Nutzen des Erlaubens, nicht die Kosten des Sperrens.
Es wird kein Google-Produkt genannt. Die Anleitung spricht von agents hosted on Google infrastructure
und belässt es dabei. Welche Funktionen Google-Agent nutzen, um im Auftrag eines Nutzers zu handeln, steht nirgends.
Was sich in der Praxis ändert
Für Verantwortliche in der Suchmaschinenoptimierung ändert sich, wen man fragen muss. Fünfzehn Jahre lang stand die Antwort auf „Lassen wir diesen Bot rein?“ in einer Datei, die das SEO-Team selbst bearbeiten konnte. Für diese Gruppe von Anfragen gilt das nicht mehr. Sie steht in der CDN-Konsole, im verwalteten Regelsatz der WAF und in den Voreinstellungen eines Bot-Erkennungsprodukts – meist verantwortet von einem anderen Team und oft von einer anderen Firma.
Es ändert sich auch, was „wir haben das längst erlaubt“ bedeutet. Die Sechs-Punkte-Liste beschreibt sechs Arten, den Agenten erlaubt zu haben und ihn trotzdem zu blockieren: die Regel an der falschen Stelle der Auswertungsreihenfolge, nur HTTP-Sperren abgedeckt, nur die Startseite abgedeckt, ein Ratenlimit pro IP ohne Ausnahme, vor Wochen kopierte IP-Bereiche, oder ein Proxy, der den identifizierenden Header entfernt. Keine dieser sechs Ursachen ist aus der robots.txt erkennbar, und keine ist in der Search Console sichtbar.
Wer in diesem Monat Crawler-Regeln überprüft: der robots.txt-Checker bleibt das richtige Werkzeug für den Googlebot und für die KI-Crawler, die die Datei befolgen. Für Google-Agent ist er es nicht – und das ist dieselbe Unterscheidung, die wir in Die drei Claude-Crawler und deine robots.txt beschrieben haben: ein Anbieter kann mehrere Agenten mit unterschiedlichen Gehorsamsregeln betreiben, und sie als einen einzigen Bot zu behandeln ist der häufigste Fehler.
Was diese Woche zu tun ist
Sieben Schritte, alle mit Bordmitteln ausführbar:
- Nach dem Token suchen. Filtere deine CDN- oder Origin-Logs der letzten 30 Tage nach der Zeichenkette
Google-Agent. Notiere die Zahl der Anfragen und die zurückgegebenen Statuscodes. - Auf die Statuscodes schauen, nicht auf die Summe. Tauchen 403, 429 oder Challenge-Antworten auf, ist die Frage beantwortet: Der Agent kommt an und kommt nicht durch.
- Verifizieren, bevor du erlaubst. Erlaube nicht allein über die User-Agent-Zeichenkette – Google warnt, dass sie gefälscht werden kann. Prüfe die IP gegen
user-triggered-agents.json. - Die Bereichsdatei automatisieren. Lade sie zeitgesteuert und vergleiche die
creationTime. Eine von Hand kopierte Liste kann binnen eines Tages veraltet sein. - Die Auswertungsreihenfolge prüfen. Stelle sicher, dass deine Erlaubnisregel vor Rechenzentrums-ASN-Sperren greift und vor jeder KI-Agenten-Kategorieregel, die dein Anbieter standardmäßig mitliefert.
- Über die Startseite hinaus testen. Wiederhole den Test für die interne Suche, eine gefilterte Liste, eine Detailseite, den Warenkorb und die dahinterliegenden XHR- oder GraphQL-Endpunkte. Das ist der Punkt, auf den die Anleitung hinweist und den fast niemand prüft.
- Die Entscheidung und ihr Datum festhalten. Erlauben und Sperren sind beide vertretbar. Nicht zu wissen, was gerade gilt, ist es nicht.
Das ist technisches SEO im wörtlichen Sinn: auf der Netzwerkebene gemacht, in den Logs überprüft.
Wo die Branche wirklich uneins ist
Vier echte Meinungsverschiedenheiten, die dieses Dokument berührt und nicht auflöst. Keine davon wird hier entschieden.
Ob Websites KI-Agenten überhaupt sperren sollten. Das eine Lager hält einen Agenten, der im Auftrag einer Person handelt, für Nutzerverkehr – ihn zu sperren heiße, diesen Nutzer zu verlieren. Das andere hält dagegen, eine Website, die einen automatisierten Strom weder messen noch begrenzen kann, solle ihn nicht standardmäßig zulassen. Niemand hat einen Umsatzvergleich zwischen zulassenden und sperrenden Websites veröffentlicht, also argumentieren beide Lager aus Prinzipien.
Ob eine dauerhafte Anweisung noch „nutzerausgelöst“ ist. Googles Kategorie ist von robots.txt ausgenommen, weil eine Person den Abruf angefordert hat. Was gilt, wenn diese Person einmal fragt und der Agent tagelang handelt, beantwortet Googles Dokumentation nicht – und davon hängt ab, ob robots.txt hier überhaupt ein brauchbarer Hebel ist.
Ob eine Dokumentationsänderung etwas über Googles Systeme aussagt. Das eine Lager liest eine datierte Seite als die verlässlichste Release Note, die Google veröffentlicht. Das andere hält entgegen, Google veröffentliche Leitfäden für Website-Betreiber und keine Spezifikationen, und beides sei wiederholt auseinandergelaufen. Google veröffentlicht keine Zuordnung von einer Dokumentationsänderung zu einer Änderung im Betrieb, also ist unbekannt, wie oft das eine das andere begleitet.
Und eine Frage, die dieses Dokument aufwirft. Wenn ein Agent robots.txt ignoriert und die Entscheidung im CDN vollzogen wird – liegt sie dann noch beim Publisher, oder hat er sie unbemerkt an die Voreinstellung seines Bot-Management-Anbieters abgegeben? Googles eigene Anleitung setzt voraus, dass Kategorieregeln gegen KI-Agenten existieren und dass die eigene Regel sie überstimmen muss. Das beschreibt eine Website, deren Zugangsrichtlinie ein Dritter geschrieben hat. Wir haben die Frage in unserem Register strittiger Themen vermerkt, ohne Urteil.
Die Meinung des Autors
Was ich hier vertrete, ist dokumentarisch – und nichts darüber hinaus.
Das ist die nützlichste Dokumentationsänderung, die Google in diesem Monat veröffentlicht hat, und zwar nicht wegen der Konfigurationshinweise. Nützlich ist sie wegen dessen, was sie einräumt. Die sechs Punkte zur Fehlersuche sind keine Theorie, sondern die Liste dessen, was bei jedem, der je eine WAF betreut hat, tatsächlich kaputtgeht. Dass Google sie aufschreiben musste, legt nahe, dass der Hinweis häufig eingeht.
Ich werde nicht behaupten, dass das eine Ranking-Änderung ankündigt. Google hat keine Messung veröffentlicht, keine Funktion genannt, kein Ergebnis versprochen und keine Richtlinie geändert – und ich fülle diese Lücke nicht mit einem erfundenen Mechanismus.
Ich werde dir auch nicht sagen, ob du den Agenten hereinlassen sollst. Das hängt davon ab, was ein über einen Vermittler ankommender Nutzer für dein Geschäft wert ist, und niemand hat die Zahl veröffentlicht, die das beantworten würde. Was ich sage, ist enger und meines Erachtens nützlicher: Die meisten Websites haben diese Entscheidung überhaupt nicht getroffen, und seit dieser Woche gibt es ein datiertes Dokument, das genau benennt, wo sie für sie getroffen wird.
Was weiterhin unbekannt ist
Wie viele Websites Google-Agent heute sperren. Google veröffentlicht es nicht. Die Fachpresse zitiert Zahlen von Sicherheitsanbietern zum Sperren von Agenten; wir haben diese Primärquellen in dieser Prüfung nicht gelesen und geben sie hier deshalb nicht wieder.
Welche Google-Funktionen den Agenten nutzen. Das Dokument sagt „Agenten auf Googles Infrastruktur“ und belässt es dabei.
Was Sperren kostet. Auf keiner der beiden Seiten ist eine Folge dokumentiert.
Wann das Signieren von Anfragen den Experimentierstatus verlässt. Google benutzt dieses Wort und nennt kein Datum.
Und wie oft sich die Bereichsdatei ändert. Wir haben zwei datierte Beobachtungen mit unterschiedlichen creationTime-Werten an aufeinanderfolgenden Tagen; das ist keine Reihe, und Google veröffentlicht keine Taktung.
Quellen
- Google, Allow Google-Agent traffic, Crawling-Dokumentation, Last updated 2026-11-17 UTC. Zweimal gelesen am 18. November 2026.
- Google, List of Google user-triggered fetchers, Last updated 2026-08-19 UTC. Gelesen am 18. November 2026.
- Google, Changelog der Crawling-Infrastruktur, Eintrag vom 17. November 2026. Gelesen am 18. November 2026.
- Google, Search-Central-Dokumentations-Changelog, neuester Eintrag vom 12. November 2026. Zweimal gelesen am 18. November 2026.
- Google, user-triggered-agents.json, creationTime 2026-11-17T15:45:49. Gelesen am 18. November 2026.
- Barry Schwartz, New Google Search Help Document On How To Allow Google-Agent Traffic, Search Engine Roundtable, 17. November 2026.
- Luis Rijo, Google lists six ways sites still block its AI agent after allowing it, PPC Land, 17. November 2026.
Keine dieser Quellen ist eine Studie, also gibt es keine Stichprobengröße zu nennen: Es sind datierte Dokumente und zwei Fachberichte. Google hat zu dieser Anleitung keine Messung veröffentlicht.